
Chatbot AI hiểu và phản hồi người dùng như thế nào?
Mục lục
- Chatbot AI là hệ thống hội thoại sử dụng AI để xử lý ngôn ngữ
- Bước đầu tiên là biến câu người dùng thành dữ liệu mô hình có thể xử lý
- Chatbot xác định ý nghĩa bằng cách đặt từ ngữ vào ngữ cảnh
- Ngữ cảnh cuộc hội thoại quyết định chatbot đang trả lời câu hỏi nào
- Chatbot có thể lấy thêm tri thức trước khi tạo câu trả lời
- Mô hình ngôn ngữ tạo câu trả lời theo từng token
- Câu trả lời còn chịu ảnh hưởng bởi hướng dẫn và cách giải mã
- Vì sao chatbot có thể trả lời rất tự nhiên nhưng vẫn sai?
- Có thể hình dung toàn bộ quá trình hoạt động của chatbot AI theo một chuỗi
Chatbot AI tiếp nhận ngôn ngữ, chuyển câu hỏi thành biểu diễn mà mô hình có thể xử lý, kết hợp ngữ cảnh và nguồn tri thức rồi tạo phản hồi từng bước. Hiểu quy trình này giúp phân biệt khả năng xử lý ngôn ngữ của AI với việc “hiểu” theo nghĩa của con người.
Khi người dùng gửi một câu hỏi, chatbot AI không đơn giản tìm một câu có sẵn rồi trả lại. Với các chatbot hiện đại dùng mô hình ngôn ngữ lớn, đầu vào được phân tách thành các đơn vị mà mô hình có thể xử lý, chuyển thành biểu diễn số, đặt trong ngữ cảnh cuộc hội thoại và đưa qua mô hình để xác định phản hồi phù hợp. Một số hệ thống còn truy xuất tài liệu, gọi công cụ hoặc lấy dữ liệu từ hệ thống bên ngoài trước khi tạo câu trả lời.
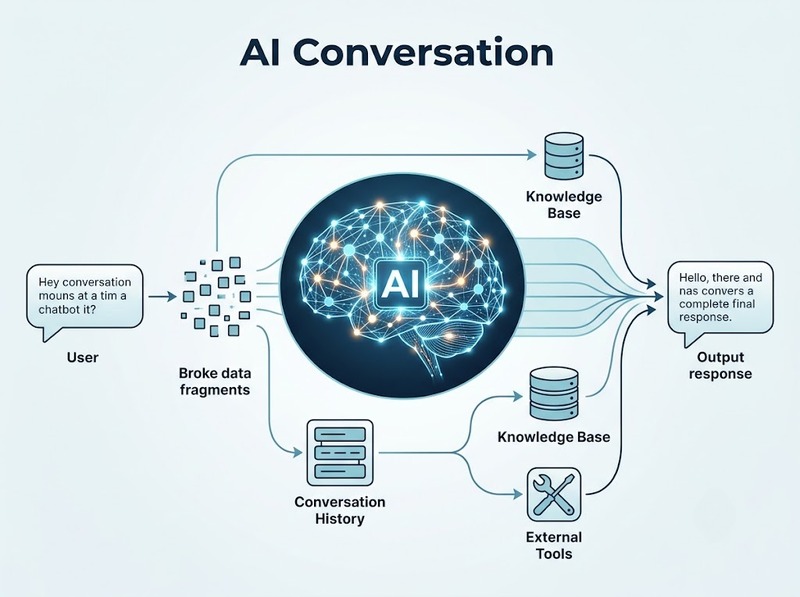
Vì vậy, quá trình “hiểu và phản hồi” nên được nhìn như một chuỗi xử lý: nhận đầu vào → biểu diễn ngôn ngữ → xác định quan hệ trong ngữ cảnh → bổ sung thông tin khi cần → sinh câu trả lời → kiểm tra và trả kết quả. Các bước này có thể được triển khai bằng nhiều thành phần riêng hoặc được tích hợp sâu trong cùng một mô hình.
Chatbot AI là hệ thống hội thoại sử dụng AI để xử lý ngôn ngữ
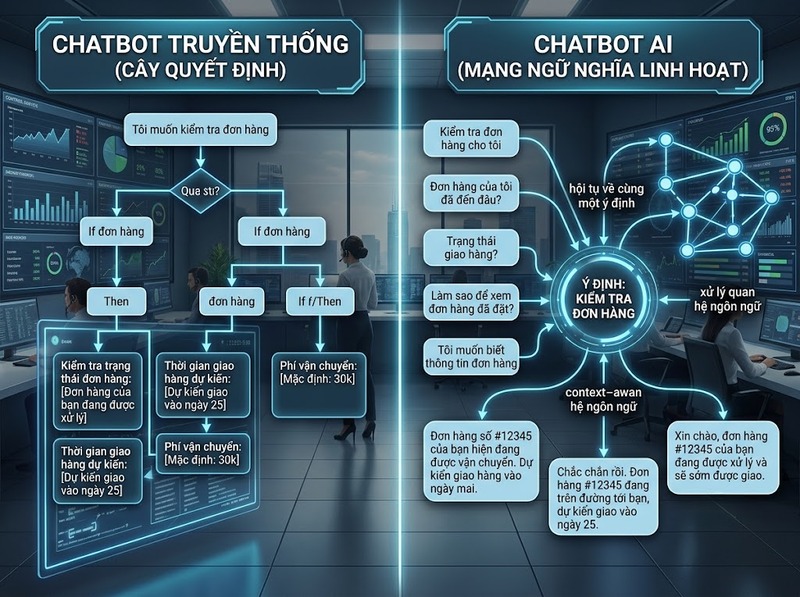
Chatbot là phần mềm giao tiếp với con người qua văn bản hoặc giọng nói. Không phải chatbot nào cũng là chatbot AI: chatbot truyền thống có thể hoạt động bằng cây quyết định, từ khóa và các câu trả lời được lập trình trước; chatbot AI sử dụng các kỹ thuật như xử lý ngôn ngữ tự nhiên, học máy và mô hình ngôn ngữ để xử lý những cách diễn đạt đa dạng hơn.
Điểm khác biệt quan trọng nằm ở cách hệ thống xác định phản hồi. Với chatbot dựa trên luật, nhà phát triển thường định nghĩa trước điều kiện kiểu “nếu người dùng hỏi X thì trả lời Y”. Hệ thống chỉ hoạt động tốt trong phạm vi những tình huống đã được dự liệu.
Chatbot AI hiện đại có thể xử lý một câu chưa từng được viết chính xác trong kịch bản. Thay vì chỉ khớp chuỗi ký tự, mô hình sử dụng các mẫu đã học để biểu diễn mối quan hệ giữa từ, câu, ngữ cảnh và yêu cầu của người dùng. Điều này cho phép những câu như “Đơn của tôi đâu rồi?”, “Kiểm tra giúp đơn hàng” và “Bao giờ hàng tới?” có thể được nhận diện là những yêu cầu có quan hệ gần nhau, dù hình thức câu khác nhau.
Tuy nhiên, chữ “hiểu” ở đây mang nghĩa xử lý và biểu diễn thông tin đủ tốt để thực hiện nhiệm vụ, không có nghĩa chatbot sở hữu trải nghiệm, ý thức hay sự thấu hiểu giống con người.
Bước đầu tiên là biến câu người dùng thành dữ liệu mô hình có thể xử lý
Máy tính không trực tiếp xử lý một câu theo cách con người nhìn thấy nó. Văn bản trước hết phải được chuyển thành một dạng số mà mô hình có thể tính toán.
Văn bản được chia thành token
Một trong những bước cơ bản là tokenization. Câu của người dùng được chia thành các đơn vị gọi là token. Token có thể tương ứng với một từ, một phần của từ, dấu câu hoặc ký tự tùy mô hình và phương pháp mã hóa. OpenAI mô tả token là các đơn vị văn bản cơ bản mà mô hình xử lý; với tiếng Anh, một quy tắc ước lượng thường dùng là khoảng 1 token cho 4 ký tự, nhưng tỷ lệ thực tế thay đổi theo ngôn ngữ và tokenizer.
Ví dụ, mô hình không nhất thiết tiếp nhận câu:
“Chatbot AI hoạt động thế nào?”
như sáu khối từ nguyên vẹn. Tokenizer có thể chia một số từ thành nhiều phần nhỏ hơn. Vì vậy, số token không đồng nghĩa với số từ.
Tokenization có hai ý nghĩa thực tế. Thứ nhất, nó tạo ra đơn vị đầu vào cho mô hình. Thứ hai, số token góp phần quyết định lượng nội dung có thể nằm trong ngữ cảnh mà chatbot xử lý ở một thời điểm.
Token được chuyển thành biểu diễn số
Sau khi có token, hệ thống ánh xạ chúng thành các vector số thường được gọi là embedding. Những vector này cho phép mạng nơ-ron thực hiện phép tính trên dữ liệu ngôn ngữ.
Một token vì thế không được xử lý chỉ như một mã định danh cố định. Trong các lớp của mô hình, biểu diễn của nó tiếp tục thay đổi dựa trên những token xung quanh. Cùng một từ có thể được xử lý khác nhau khi xuất hiện trong các ngữ cảnh khác nhau.
Đây là nền tảng để chatbot vượt qua cách xử lý dựa hoàn toàn vào từ khóa.
Chatbot xác định ý nghĩa bằng cách đặt từ ngữ vào ngữ cảnh
Trong cách mô tả truyền thống, Natural Language Processing (NLP) là lĩnh vực bao quát việc máy tính xử lý ngôn ngữ; Natural Language Understanding (NLU) tập trung vào việc diễn giải ý định, ngữ nghĩa và ngữ cảnh của đầu vào. IBM mô tả NLU là quá trình biến ngôn ngữ nói hoặc viết không có cấu trúc thành dạng dữ liệu biểu diễn nội dung và ý nghĩa.
Với chatbot dựa trên LLM, các chức năng này không nhất thiết tồn tại thành những module tách biệt. Một mô hình có thể đồng thời xử lý ngữ cảnh và chuẩn bị cho quá trình sinh phản hồi.
Cơ chế attention giúp mô hình xác định các phần liên quan
Nhiều LLM hiện đại được xây dựng trên kiến trúc Transformer. Công trình Attention Is All You Need giới thiệu Transformer dựa trên cơ chế attention thay vì phụ thuộc vào kiến trúc tuần tự kiểu recurrent hoặc convolutional trước đó.
Self-attention cho phép mô hình tính toán mức độ liên quan giữa các token trong cùng chuỗi. Nhờ đó, khi xử lý một từ hoặc cụm từ, mô hình có thể đặt trọng số lớn hơn cho những phần khác của câu hoặc cuộc hội thoại có liên quan đến nó.
Ví dụ:
“Minh đặt một chiếc laptop hôm qua. Bao giờ nó được giao?”
Để tạo phản hồi phù hợp, hệ thống cần liên hệ “nó” với chiếc laptop hoặc đơn hàng đã được đề cập trước đó. Những quan hệ kiểu này là một phần của việc mô hình hóa ngữ cảnh.
Attention không phải một cơ chế khiến máy “hiểu như người”. Nó là phương pháp tính toán giúp mô hình biểu diễn quan hệ giữa các phần của dữ liệu đầu vào.
Ngữ cảnh cuộc hội thoại quyết định chatbot đang trả lời câu hỏi nào
Một câu riêng lẻ đôi khi không đủ để xác định yêu cầu. Chatbot cần kết hợp câu mới với thông tin đã xuất hiện trước đó.
Giả sử cuộc hội thoại diễn ra như sau:
Người dùng: “Tôi đang tìm hiểu chatbot AI.”
Sau đó: “Nó có cần NLP không?”
Từ “nó” chỉ có ý nghĩa rõ ràng khi câu thứ hai được đặt cạnh thông tin trước đó. Hệ thống chatbot vì thế thường đưa một phần lịch sử hội thoại vào context cùng với yêu cầu hiện tại.
Context có thể chứa nhiều loại thông tin: câu hỏi mới, các lượt trao đổi trước, chỉ dẫn điều khiển hành vi của chatbot, tài liệu được truy xuất hoặc kết quả từ công cụ bên ngoài.
Điều này giải thích tại sao cùng một câu hỏi có thể nhận được câu trả lời khác khi nó xuất hiện trong hai cuộc hội thoại khác nhau. Mô hình không chỉ xử lý câu cuối cùng; phản hồi còn phụ thuộc vào những thông tin mà hệ thống đưa vào context.
Ngữ cảnh cũng có giới hạn. Mỗi mô hình chỉ xử lý được một lượng token nhất định trong một lần suy luận. Nếu thông tin quan trọng không còn nằm trong phần context được cung cấp, chatbot có thể không sử dụng được nó, trừ khi hệ thống có cơ chế bộ nhớ hoặc truy xuất riêng.
Chatbot có thể lấy thêm tri thức trước khi tạo câu trả lời
Thông tin dùng để trả lời không nhất thiết chỉ đến từ những mẫu mà mô hình đã học trong quá trình huấn luyện.
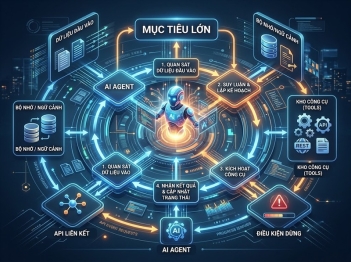
Một chatbot có thể được kết nối với cơ sở dữ liệu, tài liệu nội bộ, công cụ tìm kiếm hoặc API. Khi đó, hệ thống có thể lấy dữ liệu liên quan rồi đưa dữ liệu này vào context để mô hình sử dụng.
RAG bổ sung tài liệu liên quan vào ngữ cảnh
Một kiến trúc thường gặp là Retrieval-Augmented Generation (RAG). Thay vì yêu cầu mô hình chỉ dựa vào kiến thức được hình thành khi huấn luyện, hệ thống tìm những đoạn tài liệu có liên quan đến câu hỏi và cung cấp chúng cho mô hình trước khi sinh phản hồi. Google Cloud mô tả RAG trong chatbot như cơ chế cho phép truy xuất từ các nguồn bên ngoài như knowledge base, tài liệu nội bộ hoặc nội dung công khai.
Ví dụ, khi người dùng hỏi trạng thái một chính sách vừa được cập nhật, chatbot doanh nghiệp có thể tìm phiên bản tài liệu hiện hành rồi tạo câu trả lời dựa trên tài liệu đó.
RAG không tự động bảo đảm câu trả lời đúng. Kết quả cuối cùng còn phụ thuộc vào việc hệ thống có truy xuất đúng tài liệu, tài liệu có đáng tin cậy và mô hình có sử dụng nội dung đó chính xác hay không.
Công cụ cho phép chatbot lấy dữ liệu hoặc thực hiện phép tính
Một số chatbot còn có thể gọi công cụ. Thay vì tự đoán kết quả của phép tính, tỷ giá, trạng thái đơn hàng hay dữ liệu trong hệ thống doanh nghiệp, chatbot có thể gửi yêu cầu tới công cụ phù hợp rồi sử dụng kết quả trả về.
Ở đây cần phân biệt hai nhiệm vụ: mô hình ngôn ngữ quyết định cách diễn giải và diễn đạt, còn nguồn dữ liệu hoặc công cụ cung cấp thông tin mà mô hình không nên tự suy đoán.
Mô hình ngôn ngữ tạo câu trả lời theo từng token
Sau khi xử lý input và context, chatbot cần biến trạng thái tính toán đó thành ngôn ngữ mà người dùng có thể đọc.
Với chatbot sử dụng LLM tạo sinh, quá trình này thường diễn ra theo kiểu dự đoán token tiếp theo.
Giả sử phần đầu của phản hồi là:
“Chatbot AI xử lý ngôn ngữ bằng…”
Mô hình tính một phân phối xác suất cho những token có khả năng xuất hiện tiếp theo dựa trên toàn bộ context hiện có. Một token được lựa chọn, thêm vào chuỗi, rồi mô hình tiếp tục dự đoán token sau nó. Chu trình lặp lại cho đến khi phản hồi hoàn thành hoặc đạt điều kiện dừng.
Vì câu trả lời được tạo tuần tự như vậy, mô hình không nhất thiết “viết sẵn” toàn bộ đoạn rồi mới gửi ra. Mỗi token mới lại trở thành một phần của ngữ cảnh cho bước sinh tiếp theo.
NLG là chức năng biến thông tin thành ngôn ngữ đầu ra
Natural Language Generation (NLG) là khái niệm mô tả quá trình tạo nội dung bằng ngôn ngữ tự nhiên. Trong một mô hình chatbot hiện đại, ranh giới giữa NLU và NLG có thể không phải hai hệ thống vật lý độc lập: cùng một LLM có thể đảm nhiệm cả việc xử lý đầu vào lẫn sinh đầu ra. Về mặt chức năng, chúng vẫn giúp phân biệt hai bài toán — diễn giải nội dung người dùng và tạo ngôn ngữ phản hồi.
Câu trả lời còn chịu ảnh hưởng bởi hướng dẫn và cách giải mã
Mô hình không chỉ dựa vào câu hỏi của người dùng. Hệ thống có thể cung cấp thêm những chỉ dẫn về vai trò, quy tắc trả lời, định dạng, phạm vi kiến thức hoặc cách sử dụng công cụ.
Do đó, hai chatbot dùng cùng một họ mô hình vẫn có thể phản hồi rất khác nếu chúng có:
· Chỉ dẫn hệ thống khác nhau
· Lịch sử hội thoại khác nhau
· Nguồn dữ liệu khác nhau
· Công cụ khác nhau
· Cấu hình sinh văn bản khác nhau
Quá trình chọn token cũng không phải lúc nào cũng lấy duy nhất token có xác suất cao nhất. Tùy cấu hình giải mã, hệ thống có thể cho phép một mức biến thiên nhất định giữa những token hợp lý. Đây là một nguyên nhân khiến cùng một prompt không phải lúc nào cũng tạo ra câu chữ giống hệt nhau.
Sự linh hoạt này hữu ích cho hội thoại tự nhiên, nhưng cũng có nghĩa phản hồi của chatbot tạo sinh không nên được xem như kết quả của một bảng tra cứu hoàn toàn xác định.
Vì sao chatbot có thể trả lời rất tự nhiên nhưng vẫn sai?
Khả năng tạo ngôn ngữ và khả năng xác minh sự thật là hai vấn đề khác nhau.
LLM được tối ưu để mô hình hóa và tạo chuỗi ngôn ngữ phù hợp với context. Cơ chế đó có thể tạo một câu rất mạch lạc ngay cả khi thông tin được nêu trong câu chưa được kiểm chứng. Hiện tượng mô hình tạo ra nội dung có vẻ hợp lý nhưng không đúng thực tế thường được gọi là hallucination.
Sai lệch có thể xuất hiện ở nhiều điểm của chuỗi xử lý:
· Câu hỏi thiếu thông tin hoặc có nhiều cách hiểu
· Context không chứa dữ kiện cần thiết
· Kiến thức học được không đủ hoặc không còn phù hợp với thời điểm hiện tại
· Hệ thống truy xuất nhầm tài liệu
· Nguồn được truy xuất chứa dữ liệu sai
· Mô hình kết hợp đúng dữ kiện theo cách suy luận không đúng
· Phản hồi tạo sinh bổ sung chi tiết không được nguồn hỗ trợ
Vì thế, “chatbot hiểu câu hỏi” không kéo theo “mọi câu trả lời đều đúng”. Với nội dung có hậu quả cao hoặc yêu cầu dữ liệu chính xác, cơ chế xác minh nguồn, truy xuất dữ liệu đáng tin cậy và kiểm tra đầu ra quan trọng không kém bản thân mô hình ngôn ngữ.
Có thể hình dung toàn bộ quá trình hoạt động của chatbot AI theo một chuỗi
Khi người dùng nhập một yêu cầu bằng văn bản, một chatbot AI dựa trên LLM thường vận hành theo logic sau:
1. Nhận đầu vào: Hệ thống tiếp nhận câu hỏi và các dữ liệu liên quan
2. Token hóa: Văn bản được chuyển thành chuỗi token
3. Biểu diễn: Token được biến thành các vector để mạng nơ-ron xử lý
4. Xử lý ngữ cảnh: Mô hình phân tích quan hệ giữa câu hỏi, lịch sử hội thoại và các chỉ dẫn
5. Bổ sung dữ liệu: Nếu kiến trúc hỗ trợ, chatbot truy xuất tài liệu hoặc gọi công cụ cần thiết
6. Sinh phản hồi: Mô hình dự đoán và tạo lần lượt các token đầu ra
7. Kiểm soát đầu ra: Hệ thống có thể áp dụng thêm quy tắc an toàn, định dạng hoặc kiểm tra trước khi trả kết quả
8. Trả lời người dùng: Các token được chuyển thành văn bản; với chatbot thoại, đầu ra còn có thể được chuyển thành giọng nói
Không phải mọi chatbot đều triển khai tám bước thành tám module độc lập. Một hệ thống đơn giản có thể bỏ qua truy xuất và công cụ; một hệ thống khác có thể kết hợp nhiều chức năng trong cùng một mô hình. Chuỗi trên mô tả các chức năng cần thực hiện, không phải một kiến trúc bắt buộc cho mọi chatbot.
Chatbot AI phản hồi người dùng bằng cách biến ngôn ngữ thành dữ liệu mô hình có thể tính toán, đặt dữ liệu đó trong ngữ cảnh, xác định các quan hệ liên quan và sinh dần câu trả lời. Ở những hệ thống mở rộng, quá trình này còn kết hợp truy xuất tài liệu hoặc công cụ bên ngoài để có thêm thông tin trước khi trả lời.
Điểm quan trọng nhất là chatbot không “hiểu” theo nghĩa con người đọc rồi hình thành nhận thức giống con người. Khả năng hội thoại xuất phát từ mô hình tính toán các mẫu và quan hệ trong ngôn ngữ. Chính cơ chế đó giúp chatbot tạo phản hồi linh hoạt, nhưng cũng tạo ra giới hạn: câu trả lời có thể tự nhiên và hợp ngữ cảnh mà vẫn cần được kiểm chứng khi độ chính xác là yếu tố quan trọng.

GỬI Ý KIẾN BÌNH LUẬN
