
AI phân tích dữ liệu và phát hiện thông tin như thế nào?
Mục lục
- AI biến dữ liệu thô thành kết quả phân tích bằng cách nào?
- AI nhận diện mẫu và phát hiện bất thường trong dữ liệu
- AI sử dụng dữ liệu lịch sử để dự báo điều gì có thể xảy ra
- AI hỗ trợ quyết định bằng cách biến dự báo thành tín hiệu ưu tiên
- Độ chính xác của AI phân tích dữ liệu được đo bằng chỉ số nào?
- Khi nào kết quả phân tích của AI có thể gây hiểu sai?
AI phân tích dữ liệu bằng cách học từ dữ liệu lịch sử, nhận diện mẫu, phát hiện bất thường và tạo dự báo hoặc khuyến nghị để hỗ trợ con người ra quyết định dựa trên bằng chứng.
AI phân tích dữ liệu bằng cách sử dụng các mô hình học máy và những kỹ thuật liên quan để tìm ra quan hệ trong dữ liệu, sau đó chuyển các quan hệ đó thành dự báo, phân loại, điểm số, cảnh báo hoặc khuyến nghị. Thay vì chỉ tổng hợp những gì đã xảy ra, AI có thể học từ dữ liệu quá khứ để ước lượng điều gì có khả năng xảy ra tiếp theo hoặc phát hiện những trường hợp khác biệt so với mẫu thông thường.
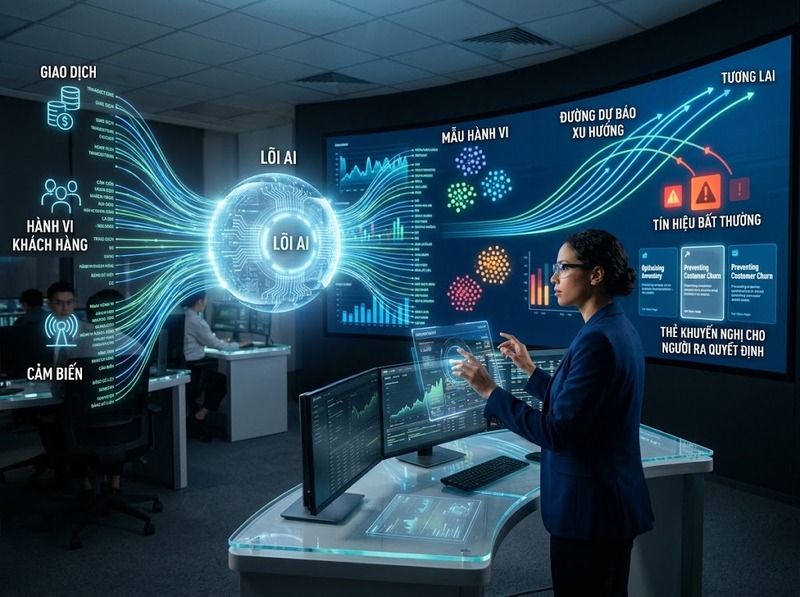
Vì vậy, giá trị của AI không nằm ở việc “đọc nhiều dữ liệu” một cách tự động, mà ở khả năng biến dữ liệu thành tín hiệu có thể hành động. IBM mô tả AI analytics là việc ứng dụng AI để xử lý và phân tích dữ liệu, sử dụng các kỹ thuật như machine learning, xử lý ngôn ngữ tự nhiên và data mining nhằm diễn giải dữ liệu, đưa ra dự báo hoặc khuyến nghị.
AI biến dữ liệu thô thành kết quả phân tích bằng cách nào?
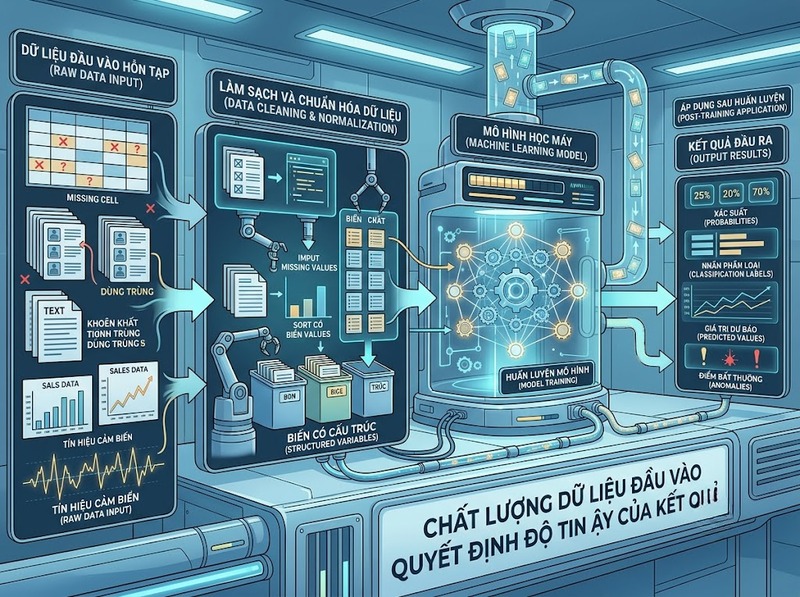
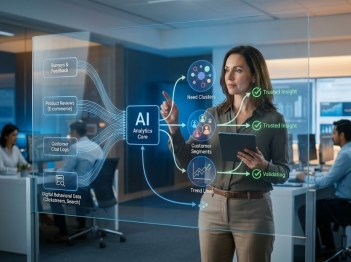
Một hệ thống AI phân tích dữ liệu thường hoạt động theo chuỗi: dữ liệu đầu vào → biểu diễn dữ liệu → học quan hệ → tạo kết quả → đánh giá kết quả. Đây là điểm khác biệt quan trọng so với một báo cáo sử dụng các công thức cố định do con người thiết lập trước.
Chuẩn bị dữ liệu để mô hình có thể học
Dữ liệu thực tế thường chứa giá trị thiếu, bản ghi trùng, sai định dạng, nhiễu hoặc các biến không trực tiếp sử dụng được. Trước khi huấn luyện mô hình, dữ liệu phải được làm sạch, chuẩn hóa và chuyển thành các biến mà thuật toán có thể xử lý.
Ví dụ, trong dữ liệu bán hàng, AI có thể sử dụng giá sản phẩm, thời điểm mua, lịch sử giao dịch, chương trình khuyến mãi và hành vi khách hàng làm tín hiệu đầu vào. Với văn bản, nội dung có thể được chuyển thành biểu diễn số để mô hình nhận biết chủ đề hoặc quan hệ ngữ nghĩa.
Chất lượng bước này ảnh hưởng trực tiếp đến kết quả phía sau. Một mô hình phức tạp không thể tự động khắc phục việc dữ liệu huấn luyện không phản ánh đúng môi trường thực tế.
Mô hình học quan hệ thay vì chỉ áp dụng công thức cố định
Trong quá trình huấn luyện, thuật toán tìm một hàm hoặc cấu trúc có khả năng liên kết dữ liệu đầu vào với kết quả cần dự đoán. Nếu mục tiêu là dự báo doanh số, mô hình học quan hệ giữa các biến như mùa vụ, giá, chương trình khuyến mãi và doanh số thực tế. Nếu mục tiêu là phát hiện giao dịch bất thường, mô hình học đặc điểm của hành vi thông thường để nhận ra những trường hợp lệch đáng kể.
Sau khi huấn luyện, mô hình có thể nhận dữ liệu mới và tạo đầu ra như xác suất, giá trị dự báo, nhãn phân loại hoặc điểm bất thường. Đây là cơ chế giúp AI chuyển dữ liệu lịch sử thành thông tin phục vụ hành động.
AI nhận diện mẫu và phát hiện bất thường trong dữ liệu
Một trong những ứng dụng quan trọng nhất của AI là nhận ra những cấu trúc lặp lại mà việc quan sát thủ công có thể bỏ sót, đặc biệt khi số lượng biến và bản ghi lớn.
Mẫu dữ liệu không nhất thiết phải là một quy luật đơn giản kiểu “A tăng thì B tăng”. Một kết quả có thể phụ thuộc đồng thời vào thời gian, nhóm khách hàng, mức giá, vị trí, hành vi trước đó và nhiều biến khác. Mô hình học máy có thể ước lượng những quan hệ đa biến này từ dữ liệu.
Chẳng hạn, trong phân tích khách hàng, AI có thể nhận diện các nhóm có hành vi tương tự dựa trên tần suất mua, giá trị đơn hàng và loại sản phẩm. Trong vận hành thiết bị, mô hình có thể phát hiện một tổ hợp nhiệt độ, độ rung và áp suất khác với trạng thái bình thường, từ đó tạo tín hiệu cần kiểm tra.
Phát hiện bất thường cũng không đồng nghĩa với việc AI đã xác định được nguyên nhân. Một điểm dữ liệu khác thường chỉ cho biết trường hợp đó đáng chú ý theo tiêu chí của mô hình. Con người hoặc một quy trình phân tích tiếp theo vẫn cần xác minh đó là gian lận, lỗi thiết bị, lỗi dữ liệu hay một hiện tượng hợp lệ nhưng hiếm gặp.
AI sử dụng dữ liệu lịch sử để dự báo điều gì có thể xảy ra
Dự báo là bước chuyển từ phân tích quá khứ sang ước lượng tương lai. AI sử dụng các quan hệ đã học trong dữ liệu lịch sử để tính toán kết quả có khả năng xuất hiện khi nhận dữ liệu mới.
Tùy bài toán, đầu ra có thể là một giá trị liên tục hoặc một xác suất. Mô hình hồi quy có thể dự báo doanh số, nhu cầu hoặc thời gian xử lý. Mô hình phân loại có thể ước lượng xác suất khách hàng rời bỏ dịch vụ, giao dịch có rủi ro hoặc một hồ sơ thuộc một nhóm nhất định.
Điều quan trọng là dự báo không phải một lời khẳng định chắc chắn về tương lai. Mô hình giả định rằng những quan hệ học được từ dữ liệu vẫn còn giá trị khi áp dụng vào điều kiện mới. Khi hành vi khách hàng, thị trường hoặc quy trình vận hành thay đổi mạnh, sai số có thể tăng.
Đó cũng là lý do mô hình cần được kiểm tra trên dữ liệu chưa dùng để huấn luyện. Google lưu ý rằng một mô hình có thể hoạt động rất tốt trên dữ liệu huấn luyện nhưng kém trên dữ liệu mới nếu bị overfitting; giá trị thực tế nằm ở khả năng tổng quát hóa sang những trường hợp chưa từng thấy.
AI hỗ trợ quyết định bằng cách biến dự báo thành tín hiệu ưu tiên
Dự báo chỉ thực sự có giá trị khi kết quả được gắn với một quyết định cụ thể. Vì thế, hệ thống AI trong phân tích dữ liệu thường không dừng ở việc trả về một con số mà chuyển kết quả thành điểm số, thứ hạng, cảnh báo hoặc đề xuất hành động.
Ví dụ, một mô hình dự đoán khả năng khách hàng rời bỏ có thể gán xác suất cho từng khách hàng. Doanh nghiệp sau đó có thể ưu tiên nhóm có rủi ro cao để kiểm tra nguyên nhân hoặc triển khai chương trình giữ chân. Trong quản lý tồn kho, dự báo nhu cầu có thể được kết hợp với lượng hàng hiện tại và thời gian cung ứng để hỗ trợ quyết định đặt hàng.
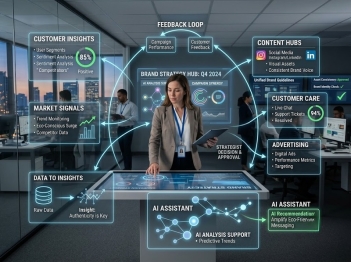
Cơ chế này tạo ra ba lớp thông tin khác nhau: dữ liệu mô tả trạng thái hiện tại, mô hình ước lượng kết quả có thể xảy ra, còn quy tắc kinh doanh xác định nên hành động như thế nào trước kết quả đó.
Vì vậy, “AI ra quyết định” và “AI hỗ trợ quyết định” không phải lúc nào cũng giống nhau. Với các quyết định có tác động lớn, việc giữ con người trong vòng kiểm soát giúp đánh giá thêm bối cảnh mà dữ liệu hoặc mô hình chưa phản ánh đầy đủ.
Độ chính xác của AI phân tích dữ liệu được đo bằng chỉ số nào?
Không tồn tại một tỷ lệ chính xác chung để kết luận mọi hệ thống AI phân tích dữ liệu là tốt hay kém. Chỉ số phải phù hợp với loại bài toán và hậu quả của từng loại sai số.
Với bài toán phân loại, các chỉ số thường gặp gồm accuracy, precision và recall. Accuracy đo tỷ lệ dự đoán đúng trên toàn bộ trường hợp, nhưng có thể gây hiểu nhầm khi dữ liệu mất cân bằng. Precision trả lời trong các trường hợp mô hình dự đoán là dương tính thì bao nhiêu trường hợp thực sự đúng; recall cho biết mô hình tìm được bao nhiêu trường hợp dương tính trong tổng số trường hợp dương tính thực tế. Việc chọn chỉ số phụ thuộc vào bài toán và chi phí của false positive so với false negative.
Với dự báo giá trị liên tục, MAE và RMSE là hai thước đo phổ biến. MAE thể hiện độ lệch tuyệt đối trung bình giữa giá trị dự báo và thực tế. RMSE nhạy hơn với những sai số lớn vì sai số được bình phương trước khi lấy trung bình và căn bậc hai.
Điều này có ý nghĩa thực tế: không nên đánh giá một mô hình chỉ bằng câu “độ chính xác đạt 95%” nếu chưa biết 95% là chỉ số gì, được đo trên tập dữ liệu nào và loại sai sót nào quan trọng đối với quyết định thực tế.
Một mô hình cũng nên được so sánh với baseline. Nếu một quy tắc đơn giản đã đạt kết quả gần tương đương, phần cải thiện do AI mang lại có thể không đủ lớn để bù chi phí triển khai, giám sát và bảo trì.
Khi nào kết quả phân tích của AI có thể gây hiểu sai?
AI có thể tìm được quan hệ trong dữ liệu, nhưng quan hệ đó không tự động trở thành sự thật phổ quát. Kết quả phụ thuộc vào dữ liệu được thu thập, cách đặt mục tiêu, phương pháp huấn luyện và điều kiện triển khai.
Một rủi ro phổ biến là dữ liệu không đại diện. Nếu tập huấn luyện chủ yếu phản ánh một nhóm khách hàng hoặc một giai đoạn thị trường nhất định, mô hình có thể hoạt động kém khi áp dụng sang nhóm hoặc điều kiện khác. Dữ liệu thực tế cũng có thể thay đổi theo thời gian, khiến những mẫu từng hữu ích không còn chính xác.
Rủi ro khác là nhầm tương quan với quan hệ nhân quả. AI có thể phát hiện hai biến thường xuất hiện cùng nhau và sử dụng quan hệ đó để dự đoán, nhưng điều này không chứng minh một biến gây ra biến kia. Vì vậy, mô hình dự báo tốt không đồng nghĩa với việc nó đã giải thích đúng nguyên nhân của hiện tượng.
Ngoài hiệu suất, hệ thống còn cần được xem xét về độ tin cậy, khả năng giải thích, thiên lệch và điều kiện sử dụng. NIST AI Risk Management Framework nhấn mạnh việc lựa chọn các phép đo phù hợp, kiểm tra hiệu suất trong điều kiện tương tự môi trường triển khai, ghi nhận giới hạn khả năng tổng quát hóa và tiếp tục theo dõi hệ thống sau khi đưa vào vận hành.
Do đó, cách sử dụng AI hiệu quả không phải là mặc định tin vào mọi đầu ra. Quy trình đáng tin cậy cần kiểm tra chất lượng dữ liệu, đánh giá mô hình bằng chỉ số phù hợp, thử nghiệm trên dữ liệu độc lập, theo dõi hiệu suất sau triển khai và đặt cơ chế con người xem xét những quyết định quan trọng.
AI phân tích dữ liệu tạo giá trị bằng cách học quan hệ từ dữ liệu, nhận diện mẫu, phát hiện bất thường, dự báo kết quả và chuyển các kết quả đó thành tín hiệu hỗ trợ quyết định. Khả năng này đặc biệt hữu ích khi dữ liệu có quy mô lớn hoặc chứa nhiều quan hệ mà quy tắc thủ công khó mô tả đầy đủ.
Tuy nhiên, AI không làm cho dữ liệu tự động trở nên đúng và cũng không loại bỏ nhu cầu đánh giá của con người. Chất lượng của phân tích phụ thuộc vào dữ liệu có đại diện hay không, mô hình có tổng quát hóa được hay không, chỉ số đánh giá có phù hợp với mục tiêu thực tế hay không và kết quả có được giám sát trong đúng bối cảnh sử dụng hay không. Khi các điều kiện đó được kiểm soát, AI trở thành công cụ giúp chuyển dữ liệu từ trạng thái lưu trữ thông tin sang một nguồn tín hiệu có thể dùng để dự báo và ra quyết định.

GỬI Ý KIẾN BÌNH LUẬN
